INNER JOIN SQL: Qué es, Sintaxis y Ejemplos Prácticos
INNER JOIN SQL es una de las instrucciones más utilizadas para consultar información almacenada en bases de datos relacionales. Permite combinar registros de dos o más tablas cuando existe una coincidencia entre sus columnas.
Imagina que tienes una tabla con clientes y otra con pedidos. ¿Cómo puedes obtener el nombre de cada cliente junto con los productos que ha comprado sin consultar ambas tablas por separado?
Aquí es donde entra en juego SQL INNER JOIN, una operación que facilita relacionar información y obtener resultados organizados mediante una sola consulta.
En esta guía aprenderás qué es INNER JOIN, cómo funciona su sintaxis, cómo utilizarlo con ejemplos prácticos y cuáles son sus diferencias frente a LEFT JOIN, RIGHT JOIN y FULL JOIN.
¿Qué es INNER JOIN en SQL?
INNER JOIN es una operación de SQL que permite combinar filas de dos tablas utilizando una condición de coincidencia entre sus columnas.
Su principal característica es que devuelve únicamente los registros que cumplen la condición establecida en ambas tablas.
Esto significa que, si un registro de la primera tabla no encuentra una coincidencia en la segunda, no aparecerá en el resultado.
Por ejemplo, supongamos que tenemos dos tablas dentro de una base de datos:
- Clientes: almacena información sobre los clientes registrados.
- Pedidos: contiene los pedidos realizados por esos clientes.
Ambas tablas están relacionadas mediante una columna llamada “cliente_id”.
Al utilizar INNER JOIN, podemos consultar qué clientes realizaron pedidos y obtener información de ambas tablas al mismo tiempo.
Sin embargo, los clientes que todavía no han realizado compras no aparecerán en los resultados.
Esta característica hace que inner join sql sea especialmente útil cuando necesitamos consultar únicamente información relacionada entre diferentes tablas.
¿Cómo funciona INNER JOIN en SQL?
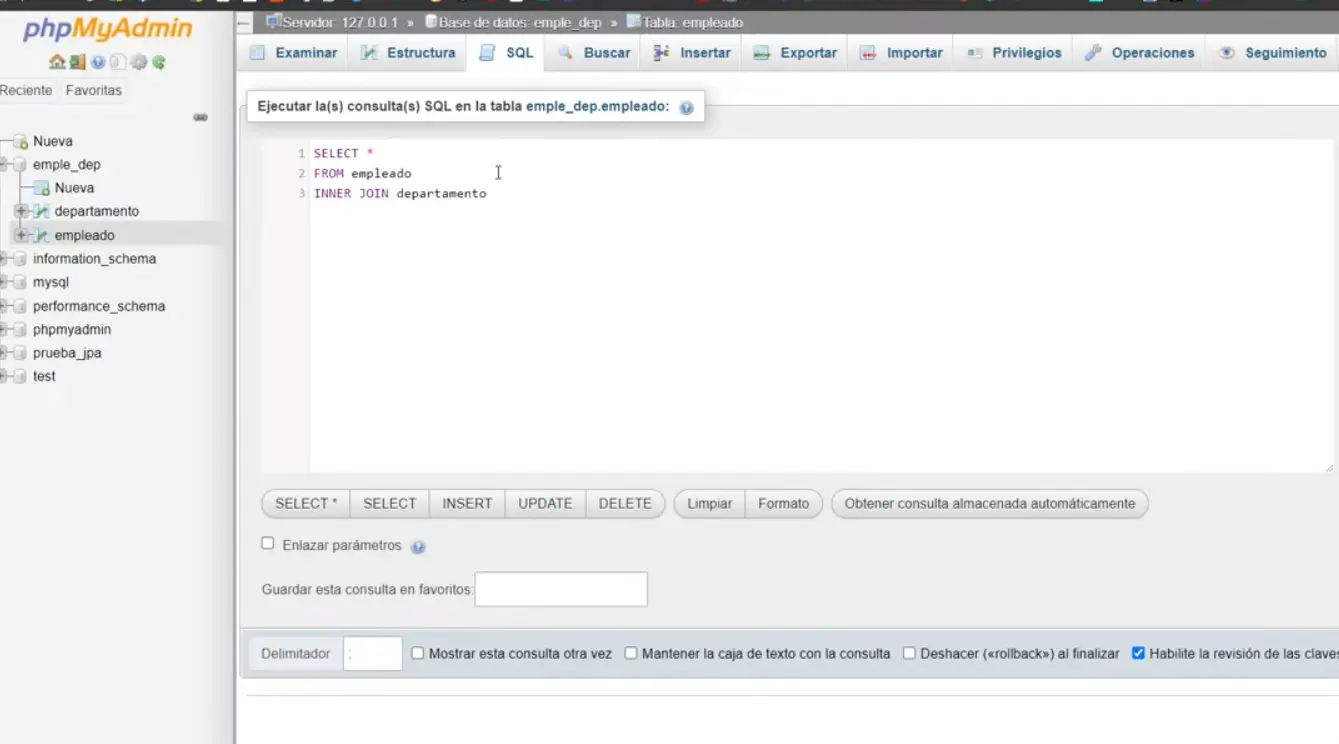
Para comprender cómo funciona INNER JOIN, lo mejor es utilizar un ejemplo con datos.
Imagina que estamos desarrollando una aplicación de comercio electrónico y tenemos las siguientes tablas.
Tabla Clientes
| cliente_id | nombre | ciudad |
|---|---|---|
| 1 | Carlos | Madrid |
| 2 | Ana | Barcelona |
| 3 | Pedro | Valencia |
| 4 | María | Sevilla |
Tabla Pedidos
| pedido_id | cliente_id | producto |
|---|---|---|
| 101 | 1 | Laptop |
| 102 | 2 | Teclado |
| 103 | 1 | Monitor |
| 104 | 5 | Mouse |
Observa que Carlos tiene dos pedidos, Ana tiene uno y Pedro y María todavía no tienen ninguno.
También existe un pedido asociado al cliente 5, que no aparece en nuestra tabla de clientes.
Este último caso representa una inconsistencia que podría ocurrir si la base de datos no aplica correctamente sus restricciones de integridad referencial.
Ahora queremos obtener los nombres de los clientes junto con los productos que compraron.
Para hacerlo utilizamos la siguiente consulta:
SELECT Clientes.nombre, Pedidos.producto
FROM Clientes
INNER JOIN Pedidos
ON Clientes.cliente_id = Pedidos.cliente_id;
Resultado del INNER JOIN
| nombre | producto |
|---|---|
| Carlos | Laptop |
| Ana | Teclado |
| Carlos | Monitor |
¿Qué ocurrió con Pedro y María?
No aparecen porque no tienen pedidos relacionados en la segunda tabla.
El pedido 104 tampoco aparece porque su cliente_id no encuentra una coincidencia en la tabla Clientes.
Además, Carlos aparece dos veces porque tiene dos pedidos diferentes.
Esto demuestra una característica importante: INNER JOIN puede devolver varias filas para un mismo registro cuando existen múltiples coincidencias.
Sintaxis de INNER JOIN en SQL
La sintaxis básica de SQL INNER JOIN es relativamente sencilla.
Necesitamos especificar las tablas que queremos relacionar y la condición que determina cuándo sus registros coinciden.
Su estructura general es:
SELECT tabla1.columna1, tabla2.columna2
FROM tabla1
INNER JOIN tabla2
ON tabla1.columna_comun = tabla2.columna_comun;
Veamos qué significa cada parte:
- SELECT: indica qué columnas queremos recuperar.
- FROM: establece la tabla inicial de la consulta.
- INNER JOIN: especifica la tabla que queremos relacionar.
- ON: define la condición utilizada para encontrar coincidencias.
- columna_comun: representa las columnas cuyos valores se compararán.
Aunque normalmente se utilizan claves primarias y foráneas, SQL no exige que las columnas comparadas tengan esos nombres ni que estén declaradas formalmente como claves.
Lo importante es que la condición permita identificar las relaciones que necesitamos consultar.
¿Es obligatorio escribir INNER JOIN completo?
No. En SQL, escribir JOIN sin especificar el tipo normalmente equivale a utilizar INNER JOIN.
Por ejemplo, estas dos consultas producen el mismo resultado:
SELECT Clientes.nombre, Pedidos.producto
FROM Clientes
INNER JOIN Pedidos
ON Clientes.cliente_id = Pedidos.cliente_id;
Y también:
SELECT Clientes.nombre, Pedidos.producto
FROM Clientes
JOIN Pedidos
ON Clientes.cliente_id = Pedidos.cliente_id;
Ambas utilizan una combinación interna.
Sin embargo, escribir INNER JOIN explícitamente puede mejorar la claridad, especialmente cuando una consulta utiliza diferentes tipos de JOIN.
Ejemplos prácticos de INNER JOIN SQL
Ahora que conocemos su funcionamiento básico, vamos a utilizar INNER JOIN en situaciones habituales del desarrollo de aplicaciones.
Estos ejemplos permiten comprender cómo relacionar información utilizando consultas SQL.
Ejemplo 1. INNER JOIN entre empleados y departamentos
Supongamos que tenemos una base de datos para administrar los empleados de una empresa.
Existen dos tablas:
Empleados
| empleado_id | nombre | departamento_id |
|---|---|---|
| 1 | Luis | 10 |
| 2 | Andrea | 20 |
| 3 | Roberto | 10 |
| 4 | Sofía | 30 |
Departamentos
| departamento_id | departamento |
|---|---|
| 10 | Tecnología |
| 20 | Finanzas |
| 40 | Marketing |
Queremos obtener el nombre de cada empleado junto con su departamento.
Podemos utilizar:
SELECT
Empleados.nombre,
Departamentos.departamento
FROM Empleados
INNER JOIN Departamentos
ON Empleados.departamento_id =
Departamentos.departamento_id;
El resultado será:
| nombre | departamento |
|---|---|
| Luis | Tecnología |
| Andrea | Finanzas |
| Roberto | Tecnología |
Sofía no aparece porque su departamento_id es 30 y no existe un departamento con ese identificador.
Este ejemplo demuestra cómo SQL INNER JOINS permite relacionar registros de empleados con información almacenada en otra tabla.
Ejemplo 2. INNER JOIN utilizando alias
Cuando trabajamos con consultas complejas, escribir constantemente los nombres completos de las tablas puede resultar incómodo.
Por esta razón, SQL permite utilizar alias de tablas.
Un alias es un nombre temporal que utilizamos para identificar una tabla dentro de una consulta.
Por ejemplo:
SELECT
e.nombre,
d.departamento
FROM Empleados AS e
INNER JOIN Departamentos AS d
ON e.departamento_id = d.departamento_id;
En este caso:
- “e” representa la tabla Empleados.
- “d” representa la tabla Departamentos.
El resultado es exactamente el mismo que en la consulta anterior.
Sin embargo, el código resulta más corto y fácil de leer.
Los alias son especialmente útiles cuando necesitamos combinar tres o más tablas.
Ejemplo 3. INNER JOIN con WHERE
¿Podemos utilizar INNER JOIN y filtrar los resultados al mismo tiempo?
Sí. Podemos combinar INNER JOIN con la cláusula WHERE para obtener únicamente los registros que cumplen una condición adicional.
Por ejemplo, queremos consultar los empleados que pertenecen al departamento de Tecnología.
SELECT
e.nombre,
d.departamento
FROM Empleados AS e
INNER JOIN Departamentos AS d
ON e.departamento_id = d.departamento_id
WHERE d.departamento = 'Tecnología';
El resultado será:
| nombre | departamento |
|---|---|
| Luis | Tecnología |
| Roberto | Tecnología |
La condición del INNER JOIN establece qué registros están relacionados.
Posteriormente, WHERE permite filtrar las filas obtenidas.
Esta combinación resulta muy útil cuando necesitamos consultar información específica dentro de una base de datos.
Ejemplo 4. INNER JOIN con ORDER BY
También podemos ordenar los resultados de una consulta utilizando ORDER BY.
Por ejemplo, queremos mostrar los empleados y sus departamentos ordenados alfabéticamente.
SELECT
e.nombre,
d.departamento
FROM Empleados AS e
INNER JOIN Departamentos AS d
ON e.departamento_id = d.departamento_id
ORDER BY e.nombre ASC;
La palabra ASC indica que los resultados deben ordenarse de forma ascendente.
Si utilizamos DESC, el orden será descendente.
Esta funcionalidad es especialmente útil para generar reportes y mostrar información organizada dentro de una aplicación.
Ejemplo 5. INNER JOIN con tres tablas
Hasta ahora hemos utilizado INNER JOIN para combinar dos tablas.
Pero ¿qué ocurre cuando necesitamos relacionar información almacenada en tres o más tablas?
Podemos utilizar múltiples instrucciones INNER JOIN dentro de una misma consulta.
Imagina una base de datos con estas tablas:
- Clientes: contiene los datos personales.
- Pedidos: almacena los pedidos realizados.
- Productos: contiene la información de los productos.
Supongamos que Pedidos incluye las columnas “cliente_id” y “producto_id”, mientras que Productos tiene “producto_id”, “nombre” y “precio”.
Queremos obtener el nombre del cliente, el producto comprado y su precio.
SELECT
c.nombre AS cliente,
p.nombre AS producto,
p.precio
FROM Pedidos AS pe
INNER JOIN Clientes AS c
ON pe.cliente_id = c.cliente_id
INNER JOIN Productos AS p
ON pe.producto_id = p.producto_id;
La consulta relaciona las tres tablas mediante dos operaciones INNER JOIN.
Primero conecta los pedidos con sus clientes y después relaciona esos pedidos con los productos correspondientes.
Este tipo de consulta es frecuente en sistemas de inventario, plataformas comerciales y aplicaciones empresariales.
Es importante mencionar que este ejemplo supone que cada pedido hace referencia a un producto.
En sistemas comerciales más complejos, normalmente se utiliza una tabla adicional para almacenar los detalles de cada pedido.
¿Cuál es la diferencia entre INNER JOIN y LEFT JOIN?
Una de las preguntas más habituales al aprender SQL es cuál es la diferencia entre INNER JOIN y LEFT JOIN.
Aunque ambas operaciones permiten combinar tablas, presentan diferencias importantes.
INNER JOIN devuelve únicamente los registros que cumplen la condición de coincidencia entre las tablas.
En cambio, LEFT JOIN devuelve todos los registros de la tabla izquierda, incluso cuando no existen coincidencias en la tabla derecha.
Cuando no encuentra una coincidencia, las columnas correspondientes a la tabla derecha contienen valores NULL.
Ejemplo de LEFT JOIN
Utilicemos nuevamente nuestras tablas Clientes y Pedidos.
SELECT
c.nombre,
p.producto
FROM Clientes AS c
LEFT JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
El resultado será:
| nombre | producto |
|---|---|
| Carlos | Laptop |
| Carlos | Monitor |
| Ana | Teclado |
| Pedro | NULL |
| María | NULL |
Observa que Pedro y María aparecen aunque no tengan pedidos.
Esto sucede porque LEFT JOIN conserva todos los registros de la tabla situada a la izquierda.
INNER JOIN vs JOIN LEFT
Aunque algunas personas buscan esta operación como join left, la sintaxis correcta en SQL es LEFT JOIN.
La diferencia principal puede resumirse así:
| Característica | INNER JOIN | LEFT JOIN |
|---|---|---|
| Devuelve coincidencias | Sí | Sí |
| Incluye registros sin coincidencia de la tabla izquierda | No | Sí |
| Puede generar valores NULL por ausencia de coincidencia | No, por sí mismo | Sí |
| Uso habitual | Consultar relaciones existentes | Consultar registros con o sin relaciones |
Por ejemplo, si necesitas conocer únicamente los clientes que realizaron compras, INNER JOIN es una buena opción.
Pero si quieres obtener todos los clientes, incluyendo aquellos que todavía no compraron, LEFT JOIN resulta más apropiado.
¿Qué diferencia existe entre INNER JOIN y RIGHT JOIN?
RIGHT JOIN funciona de manera similar a LEFT JOIN, pero conserva todos los registros de la tabla situada a la derecha.
Esto significa que devuelve las coincidencias y también los registros de la tabla derecha que no tienen una relación correspondiente.
Cuando no encuentra una coincidencia, las columnas de la tabla izquierda contienen NULL.
Ejemplo de RIGHT JOIN
Utilicemos las mismas tablas:
SELECT
c.nombre,
p.producto
FROM Clientes AS c
RIGHT JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
El resultado será:
| nombre | producto |
|---|---|
| Carlos | Laptop |
| Ana | Teclado |
| Carlos | Monitor |
| NULL | Mouse |
El pedido correspondiente al producto Mouse aparece porque RIGHT JOIN conserva todos los registros de Pedidos.
Sin embargo, su nombre de cliente aparece como NULL porque no existe una coincidencia en la tabla Clientes.
Este comportamiento permite identificar información que existe en una tabla, pero que no tiene registros relacionados en otra.
Ten en cuenta que algunos motores de bases de datos, como SQLite, incorporaron soporte para RIGHT JOIN en versiones relativamente recientes.
Por eso, siempre conviene verificar la compatibilidad del motor y la versión utilizada.
INNER JOIN vs LEFT JOIN vs RIGHT JOIN vs FULL JOIN
Además de INNER JOIN, SQL permite utilizar diferentes tipos de JOIN según los resultados que necesitemos obtener.
Comprender sus diferencias es importante para evitar errores al consultar información relacionada.
| Tipo de JOIN | Comportamiento |
|---|---|
| INNER JOIN | Devuelve únicamente las filas que cumplen la condición de coincidencia. |
| LEFT JOIN | Devuelve todas las filas de la tabla izquierda y las coincidencias de la derecha. |
| RIGHT JOIN | Devuelve todas las filas de la tabla derecha y las coincidencias de la izquierda. |
| FULL OUTER JOIN | Devuelve todas las filas de ambas tablas, tengan o no coincidencias. |
¿Qué es FULL OUTER JOIN?
FULL OUTER JOIN combina el comportamiento de LEFT JOIN y RIGHT JOIN.
Devuelve los registros relacionados y también aquellos que no encuentran coincidencias en cualquiera de las tablas.
Su sintaxis general es:
SELECT
c.nombre,
p.producto
FROM Clientes AS c
FULL OUTER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
Utilizando los datos anteriores, el resultado incluiría:
| nombre | producto |
|---|---|
| Carlos | Laptop |
| Ana | Teclado |
| Carlos | Monitor |
| Pedro | NULL |
| María | NULL |
| NULL | Mouse |
Este tipo de JOIN resulta útil cuando necesitamos identificar tanto las coincidencias como los registros que no tienen relación.
Sin embargo, no todos los motores de bases de datos admiten directamente FULL OUTER JOIN.
Por ejemplo, MySQL no proporciona soporte nativo para esta operación, por lo que puede ser necesario utilizar otras estrategias.
INNER JOIN con múltiples condiciones
En determinadas situaciones, relacionar tablas mediante una sola columna no es suficiente.
Podemos establecer varias condiciones dentro de la cláusula ON utilizando operadores lógicos.
Por ejemplo, imaginemos que tenemos dos tablas con información de ventas:
- Ventas, que contiene los identificadores de clientes y sucursales.
- Clientes, que contiene los identificadores de clientes y sucursales.
Queremos relacionar los registros únicamente cuando coincidan tanto el cliente como la sucursal.
SELECT
v.venta_id,
c.nombre
FROM Ventas AS v
INNER JOIN Clientes AS c
ON v.cliente_id = c.cliente_id
AND v.sucursal_id = c.sucursal_id;
En este ejemplo utilizamos el operador AND para establecer dos condiciones.
El resultado incluirá únicamente las filas donde ambas condiciones sean verdaderas.
Esta técnica resulta especialmente útil cuando trabajamos con claves compuestas o relaciones que dependen de varios campos.
INNER JOIN con funciones de agregación
Otra posibilidad es combinar INNER JOIN con funciones como COUNT, SUM y AVG.
Estas funciones permiten realizar cálculos utilizando información relacionada entre tablas.
Por ejemplo, podemos consultar cuántos pedidos ha realizado cada cliente.
SELECT
c.nombre,
COUNT(p.pedido_id) AS total_pedidos
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id
GROUP BY c.cliente_id, c.nombre;
El resultado será:
| nombre | total_pedidos |
|---|---|
| Carlos | 2 |
| Ana | 1 |
La función COUNT cuenta los pedidos asociados a cada cliente.
Mientras tanto, GROUP BY agrupa los registros para calcular el total correspondiente.
Pedro y María no aparecen porque no tienen pedidos relacionados.
Si necesitáramos mostrar también a los clientes sin pedidos, podríamos utilizar LEFT JOIN y contar una columna no nula de la tabla Pedidos.
¿Cómo utilizar INNER JOIN con claves primarias y foráneas?
Las bases de datos relacionales utilizan claves para identificar registros y establecer relaciones entre tablas.
Dos conceptos especialmente importantes son:
- Clave primaria (PRIMARY KEY): identifica de manera única cada registro de una tabla.
- Clave foránea (FOREIGN KEY): establece una referencia hacia una clave de otra tabla, normalmente su clave primaria.
Por ejemplo, podemos crear una tabla Clientes utilizando la siguiente estructura:
CREATE TABLE Clientes (
cliente_id INT PRIMARY KEY,
nombre VARCHAR(100)
);
Después, podemos crear una tabla Pedidos relacionada con Clientes.
CREATE TABLE Pedidos (
pedido_id INT PRIMARY KEY,
cliente_id INT,
producto VARCHAR(100),
FOREIGN KEY (cliente_id)
REFERENCES Clientes(cliente_id)
);
La clave foránea permite mantener la integridad referencial entre ambas tablas.
Esto ayuda a evitar que se almacenen pedidos asociados a clientes inexistentes, siempre que la restricción esté activa y se aplique correctamente.
Posteriormente, podemos consultar la información relacionada mediante INNER JOIN.
SELECT
c.nombre,
p.producto
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
La relación entre claves facilita comprender qué columnas deben utilizarse para combinar los registros.
Si estás aprendiendo a diseñar bases de datos, también resulta útil familiarizarte con herramientas como MySQL Workbench, que permite administrar bases de datos y trabajar con sus estructuras.
Errores comunes al utilizar INNER JOIN SQL
Aunque INNER JOIN tiene una sintaxis sencilla, existen errores que pueden provocar resultados incorrectos o consultas poco eficientes.
Conocerlos desde el principio te ayudará a escribir instrucciones SQL más claras.
1. Olvidar la condición ON
Uno de los errores más importantes consiste en no establecer correctamente la condición que relaciona las tablas.
Por ejemplo:
SELECT \*
FROM Clientes
CROSS JOIN Pedidos;
Esta consulta utiliza CROSS JOIN y genera todas las combinaciones posibles entre las filas de ambas tablas.
Si tenemos 100 clientes y 200 pedidos, el resultado tendrá 20,000 filas.
Esto puede generar un volumen considerable de información innecesaria.
Por esa razón, es importante utilizar la condición de relación apropiada cuando necesitamos consultar registros coincidentes.
2. Relacionar columnas incorrectas
Otro error frecuente consiste en comparar columnas que no representan la misma relación.
Por ejemplo:
SELECT \*
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.pedido_id;
Aunque esta consulta puede ejecutarse correctamente, su condición no representa la relación esperada entre clientes y pedidos.
Lo correcto sería comparar “cliente_id” de ambas tablas.
SELECT \*
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
Este tipo de error puede ser difícil de identificar porque la consulta no necesariamente produce un mensaje de error.
Simplemente devuelve información incorrecta.
3. No utilizar alias en consultas complejas
Cuando varias tablas contienen columnas con el mismo nombre, SQL puede generar errores de ambigüedad.
Por ejemplo, si ambas tablas tienen una columna llamada “cliente_id”, conviene indicar a cuál pertenece cada referencia.
SELECT
c.cliente_id,
c.nombre,
p.producto
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
Utilizar alias facilita la lectura y reduce la posibilidad de confundir columnas.
4. Pensar que INNER JOIN elimina duplicados
INNER JOIN no elimina automáticamente las filas duplicadas.
Si un cliente tiene cinco pedidos, puede aparecer cinco veces en el resultado.
Esto es completamente normal porque existen cinco coincidencias.
Si necesitas obtener una lista de clientes únicos que tengan pedidos, puedes utilizar DISTINCT.
SELECT DISTINCT
c.cliente_id,
c.nombre
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
DISTINCT elimina las filas duplicadas del resultado seleccionado.
Sin embargo, no modifica los registros almacenados en las tablas originales.
5. Utilizar SELECT * innecesariamente
Aunque SELECT * resulta cómodo durante las pruebas, puede recuperar columnas que realmente no necesitamos.
Por ejemplo:
SELECT \*
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
Si ambas tablas contienen numerosas columnas, la consulta puede devolver una cantidad considerable de información.
Una alternativa es seleccionar únicamente los campos necesarios.
SELECT
c.nombre,
p.producto
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
Esta práctica mejora la claridad de la consulta y puede reducir la cantidad de datos transferidos.
¿Cómo mejorar el rendimiento de INNER JOIN?
Cuando trabajamos con bases de datos pequeñas, las diferencias de rendimiento pueden pasar desapercibidas.
Sin embargo, en sistemas que almacenan millones de registros, una consulta mal diseñada puede afectar considerablemente los tiempos de respuesta.
Existen diferentes prácticas que pueden ayudar a optimizar las consultas con SQL INNER JOINS.
Crear índices en columnas utilizadas para relaciones
Los índices permiten que el motor de base de datos encuentre determinados registros de manera más eficiente.
Por ejemplo, si consultamos frecuentemente los pedidos de cada cliente, podría resultar conveniente crear un índice sobre “cliente_id” en la tabla Pedidos.
CREATE INDEX idx_pedidos_cliente
ON Pedidos(cliente_id);
Este índice puede ayudar al motor de base de datos a localizar los pedidos asociados a un cliente.
Sin embargo, no todos los índices mejoran todas las consultas.
Su utilidad depende del volumen de información, la distribución de los datos y el plan de ejecución utilizado.
Seleccionar únicamente las columnas necesarias
Evitar consultas con SELECT * puede reducir la cantidad de información recuperada.
Esto resulta especialmente útil cuando las tablas contienen campos extensos o numerosos registros.
Utilizar filtros apropiados
Aplicar condiciones mediante WHERE puede reducir la cantidad de filas devueltas.
Por ejemplo:
SELECT
c.nombre,
p.producto
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id
WHERE c.ciudad = 'Madrid';
Esta consulta recupera únicamente los pedidos de clientes registrados en Madrid.
Dependiendo del motor de base de datos, el optimizador puede utilizar esta condición para reducir el trabajo necesario.
Analizar el plan de ejecución
Los motores de bases de datos proporcionan herramientas para analizar cómo se ejecutan las consultas.
Por ejemplo, en MySQL podemos utilizar EXPLAIN.
EXPLAIN
SELECT
c.nombre,
p.producto
FROM Clientes AS c
INNER JOIN Pedidos AS p
ON c.cliente_id = p.cliente_id;
El resultado permite examinar aspectos relacionados con los índices, las tablas consultadas y las estrategias de acceso a los datos.
Comprender los planes de ejecución es una habilidad importante cuando necesitamos optimizar aplicaciones que utilizan bases de datos relacionales.
Para administrar y analizar bases de datos PostgreSQL, también puedes utilizar pgAdmin, una herramienta que facilita la ejecución y revisión de consultas SQL.
¿Cuándo conviene utilizar INNER JOIN?
INNER JOIN resulta especialmente útil cuando necesitamos obtener únicamente información que tenga una relación válida entre diferentes tablas.
Algunos casos habituales incluyen:
- Consultar los pedidos realizados por clientes registrados.
- Obtener empleados asociados a departamentos existentes.
- Mostrar productos relacionados con sus categorías.
- Consultar estudiantes inscritos en determinados cursos.
- Relacionar facturas con sus respectivos clientes.
- Generar reportes utilizando información distribuida en diferentes tablas.
Sin embargo, INNER JOIN no siempre es la mejor opción.
Si necesitas incluir registros que todavía no tienen relaciones, puede resultar más conveniente utilizar LEFT JOIN o RIGHT JOIN.
La elección depende del problema que quieras resolver y de la información que necesites obtener.
Preguntas frecuentes sobre INNER JOIN SQL
¿Para qué sirve INNER JOIN en SQL?
INNER JOIN sirve para combinar registros de dos o más tablas utilizando una condición de coincidencia.
Se utiliza cuando necesitamos consultar información relacionada y excluir las filas que no cumplen dicha condición.
¿Cuál es la diferencia entre JOIN e INNER JOIN?
En SQL, escribir JOIN sin especificar el tipo equivale normalmente a utilizar INNER JOIN.
Por lo tanto, ambas instrucciones permiten obtener los registros que cumplen la condición de coincidencia entre las tablas.
¿INNER JOIN puede utilizarse con más de dos tablas?
Sí. Podemos utilizar múltiples operaciones INNER JOIN para relacionar tres o más tablas dentro de una misma consulta.
Cada JOIN incorpora una nueva relación mediante la condición correspondiente.
¿Qué sucede si INNER JOIN no encuentra coincidencias?
Si una fila no cumple la condición de relación, no aparece en el resultado.
Cuando ninguna fila de las tablas cumple la condición, la consulta devuelve un conjunto de resultados vacío.
¿INNER JOIN devuelve valores NULL?
INNER JOIN no genera valores NULL para representar filas sin coincidencia, como ocurre con los JOIN externos.
Sin embargo, puede devolver valores NULL si las columnas seleccionadas ya contienen esos valores en los registros que sí coinciden.
¿Qué diferencia existe entre INNER JOIN y RIGHT JOIN?
INNER JOIN devuelve únicamente las filas coincidentes.
RIGHT JOIN conserva todas las filas de la tabla derecha, incluso cuando no existe una coincidencia en la tabla izquierda.
¿INNER JOIN es más rápido que LEFT JOIN?
No necesariamente.
El rendimiento depende del motor de base de datos, los índices disponibles, las condiciones de consulta y la distribución de los registros.
En determinadas situaciones, el optimizador puede generar planes de ejecución similares para ambos tipos de JOIN.
¿Se puede utilizar INNER JOIN con WHERE?
Sí. INNER JOIN y WHERE pueden utilizarse dentro de la misma consulta.
La cláusula ON establece la condición de relación y WHERE permite aplicar filtros adicionales sobre los resultados.
¿Se puede utilizar INNER JOIN sin claves foráneas?
Sí. INNER JOIN no requiere que exista una restricción FOREIGN KEY entre las tablas.
Puede relacionar columnas mediante una condición válida, aunque no exista una clave foránea declarada.
Sin embargo, utilizar claves y restricciones apropiadas ayuda a mantener la integridad de los datos.
¿INNER JOIN funciona en MySQL, SQL Server y PostgreSQL?
Sí. INNER JOIN es una operación estándar de SQL compatible con los principales sistemas de gestión de bases de datos relacionales.
Su sintaxis básica es prácticamente la misma en MySQL, PostgreSQL, SQL Server y SQLite.
Conclusión: ¿por qué aprender INNER JOIN SQL?
INNER JOIN SQL es una de las operaciones fundamentales para trabajar con bases de datos relacionales.
Permite consultar información distribuida en diferentes tablas, establecer relaciones entre registros y obtener únicamente los datos que cumplen determinadas condiciones.
Aprender a utilizar SQL INNER JOIN también facilita comprender operaciones relacionadas como LEFT JOIN, RIGHT JOIN y FULL OUTER JOIN.
Además, combinar INNER JOIN con WHERE, GROUP BY, ORDER BY y funciones de agregación permite construir consultas más completas para aplicaciones y reportes.
Lo más importante es comprender cómo se relacionan las tablas y qué resultados necesitas obtener antes de escribir la consulta.
Una vez que domines este concepto, podrás trabajar con estructuras de bases de datos más complejas y desarrollar consultas SQL de manera más eficiente.